Review – GIGABYTE AI TOP ATOM
Benchmark-uri
Asa cum probabil va asteptati deja, eram curios cum se descurca GIGABYTE AI TOP ATOM in diverse scenarii, mai ales in conditiile in care in ultima luna am testat mai multe solutii pe echivalentul Windows / laptop, NVIDIA RTX Spark. Desigur, nu putem realiza o comparatie directa intre platforme, anumite utilitare folosite de noi pe Windows nefiind disponibile sub Linux (de exemplu Procyon). Asta nu inseamna insa ca nu am pus Spark-ul la treaba asa cum se cuvine.
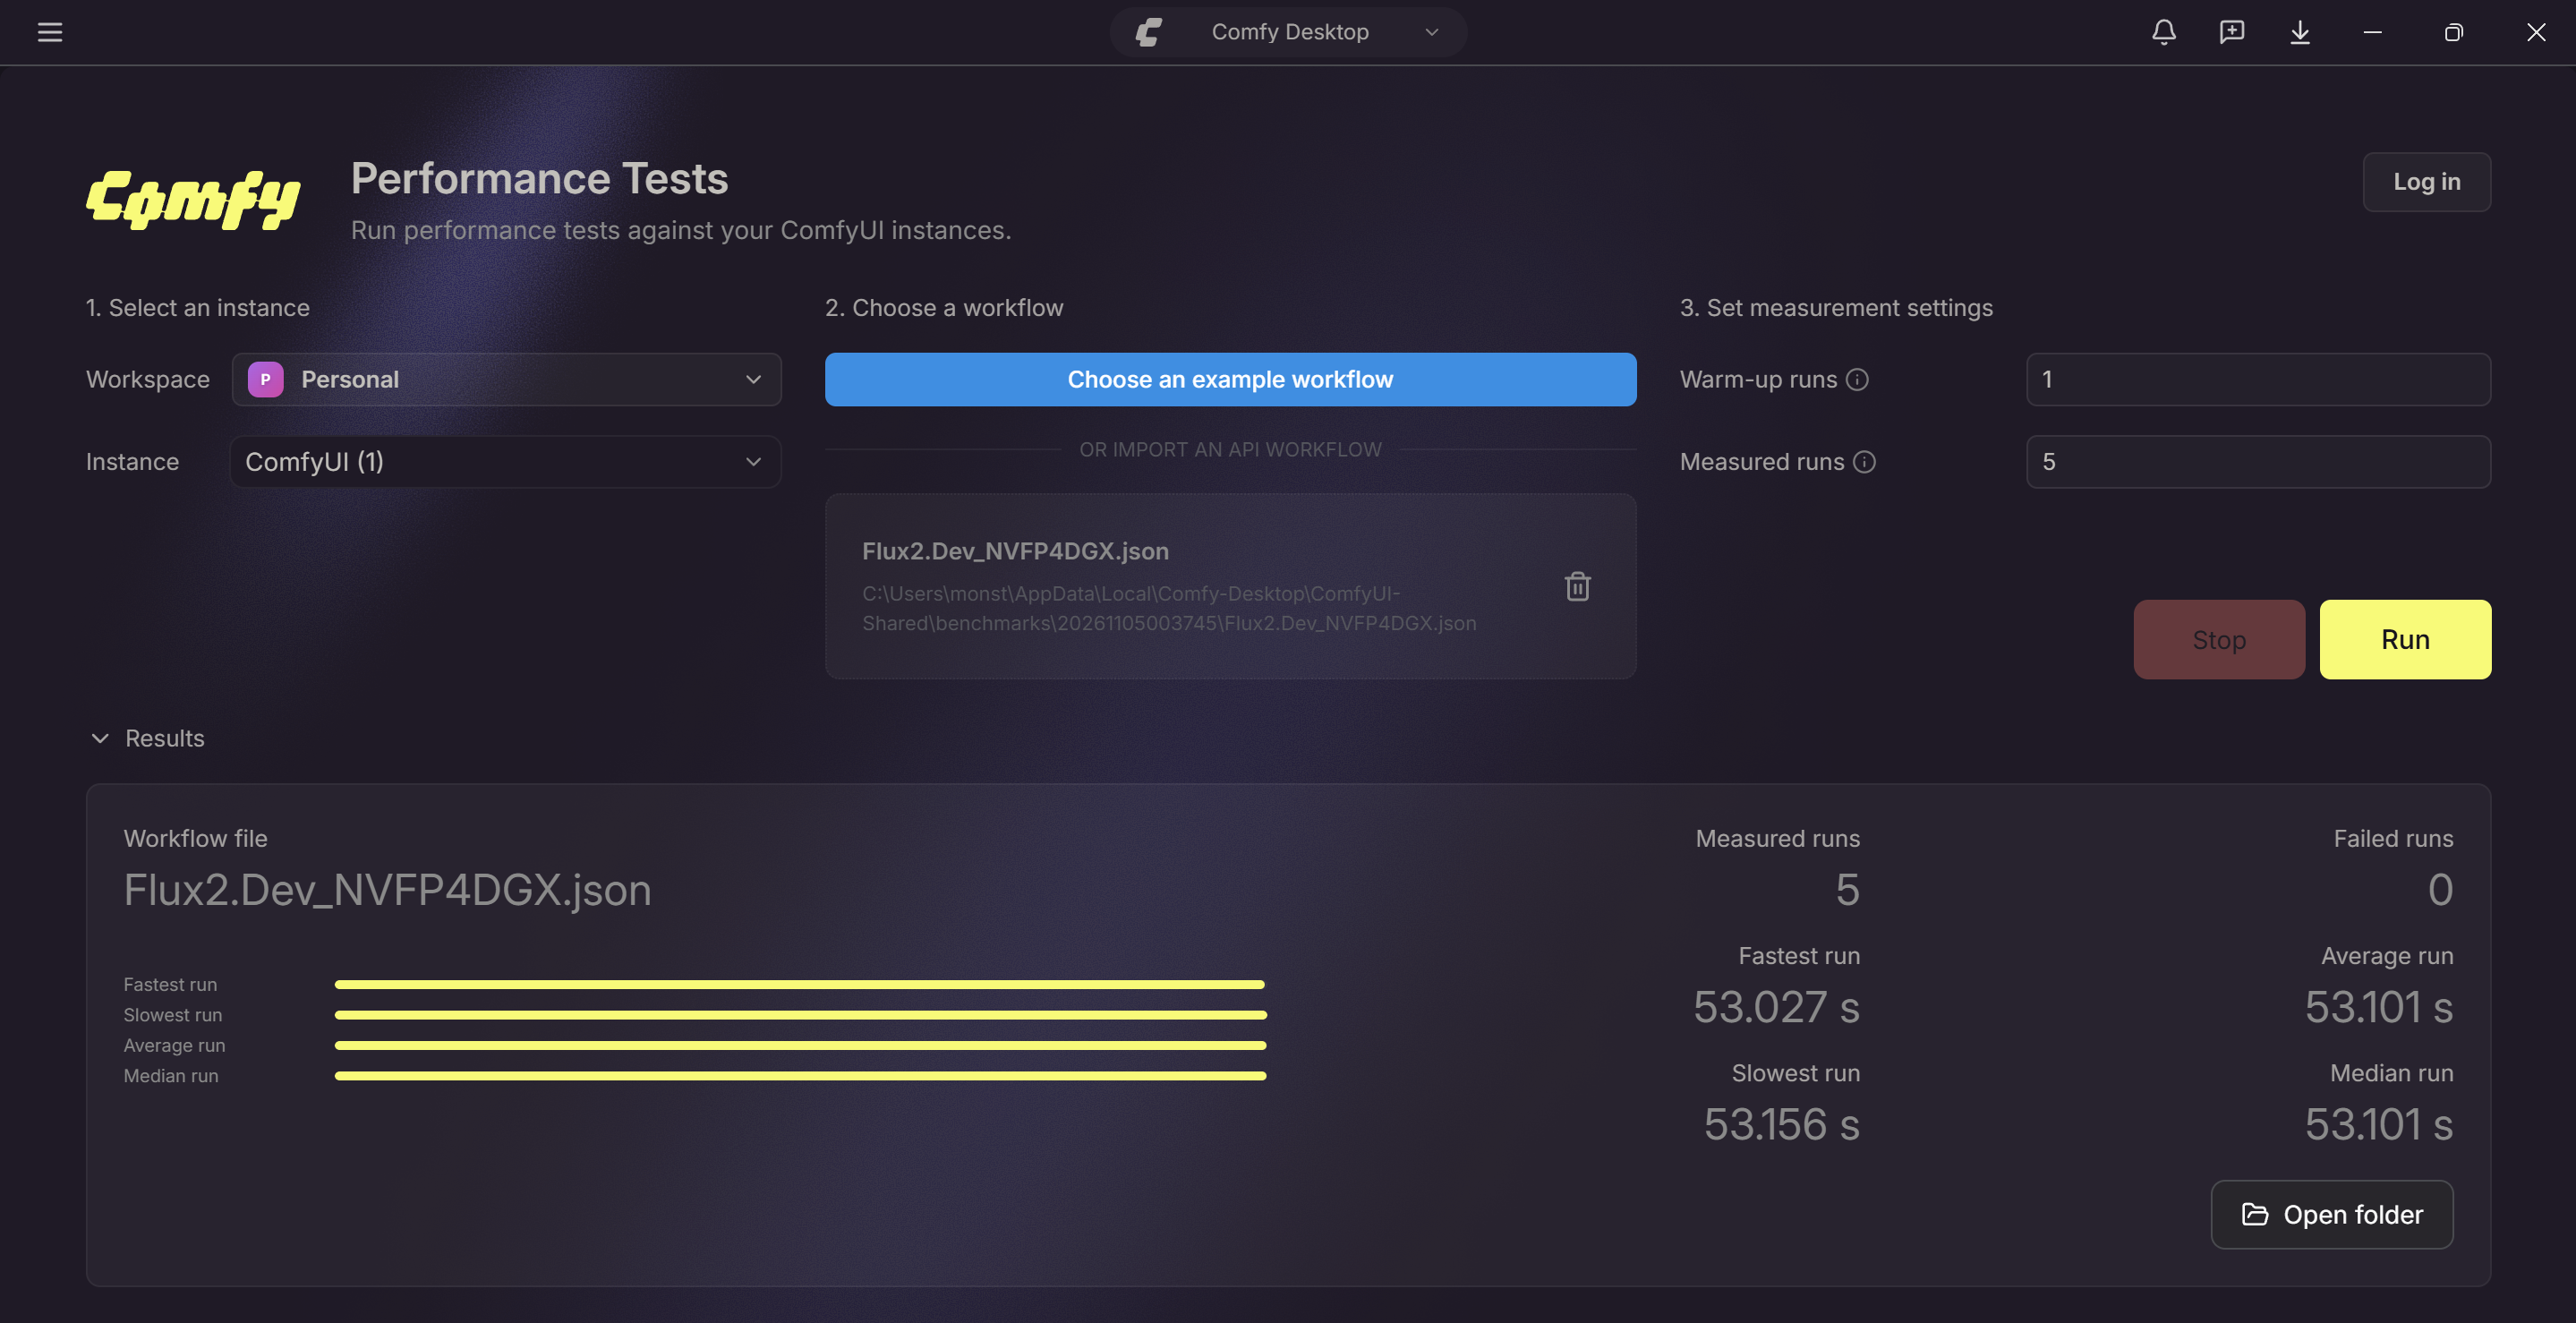
Astfel, primul scenariu a fost reprezentat de testul ComfyUI folosit si in review-urile RTX Spark. In acest scop, am folosit interfata grafica instalata pe laptop, generarea efectiva avand insa loc pe AI TOP ATOM. Desigur, RTX Spark are avantajul frecventei memoriei (LPDDR5X 9400 fata de 8533), precum si al faptului ca intregul proces a fost rulat pe aceeasi masina. Chiar si asa, diferenta intre rezultate este destul de mica, AI TOP ATOM obtinand aceeasi performanta cu RTX Spark N20 ruland pe acumulator, sau N18 ruland conectat la alimentator.
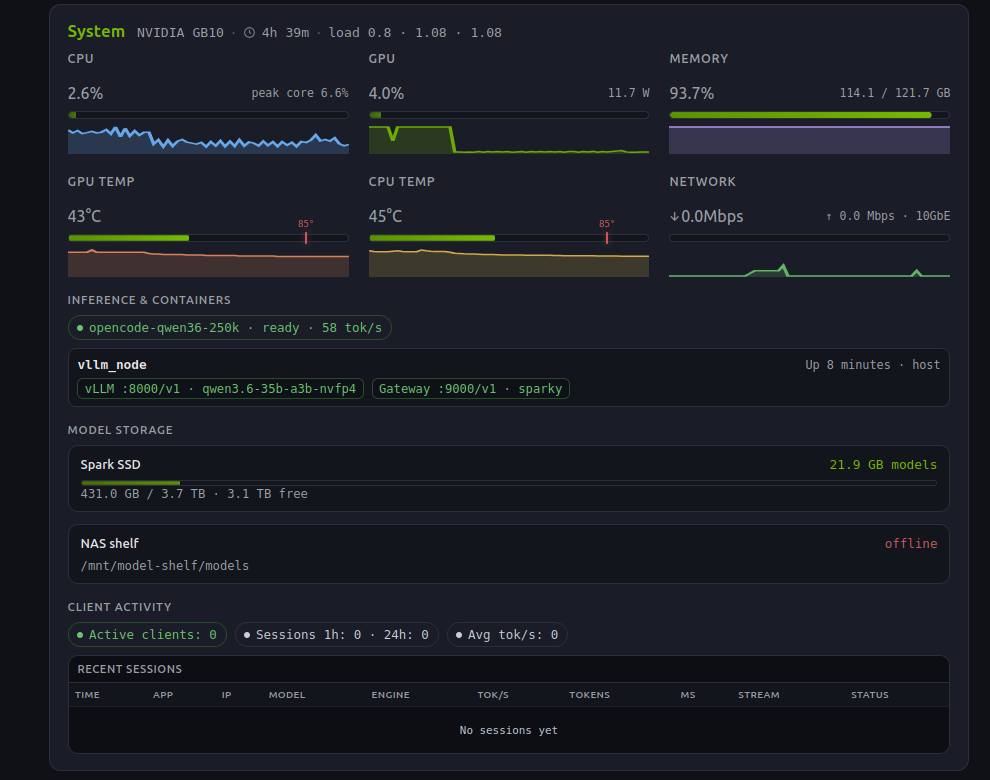
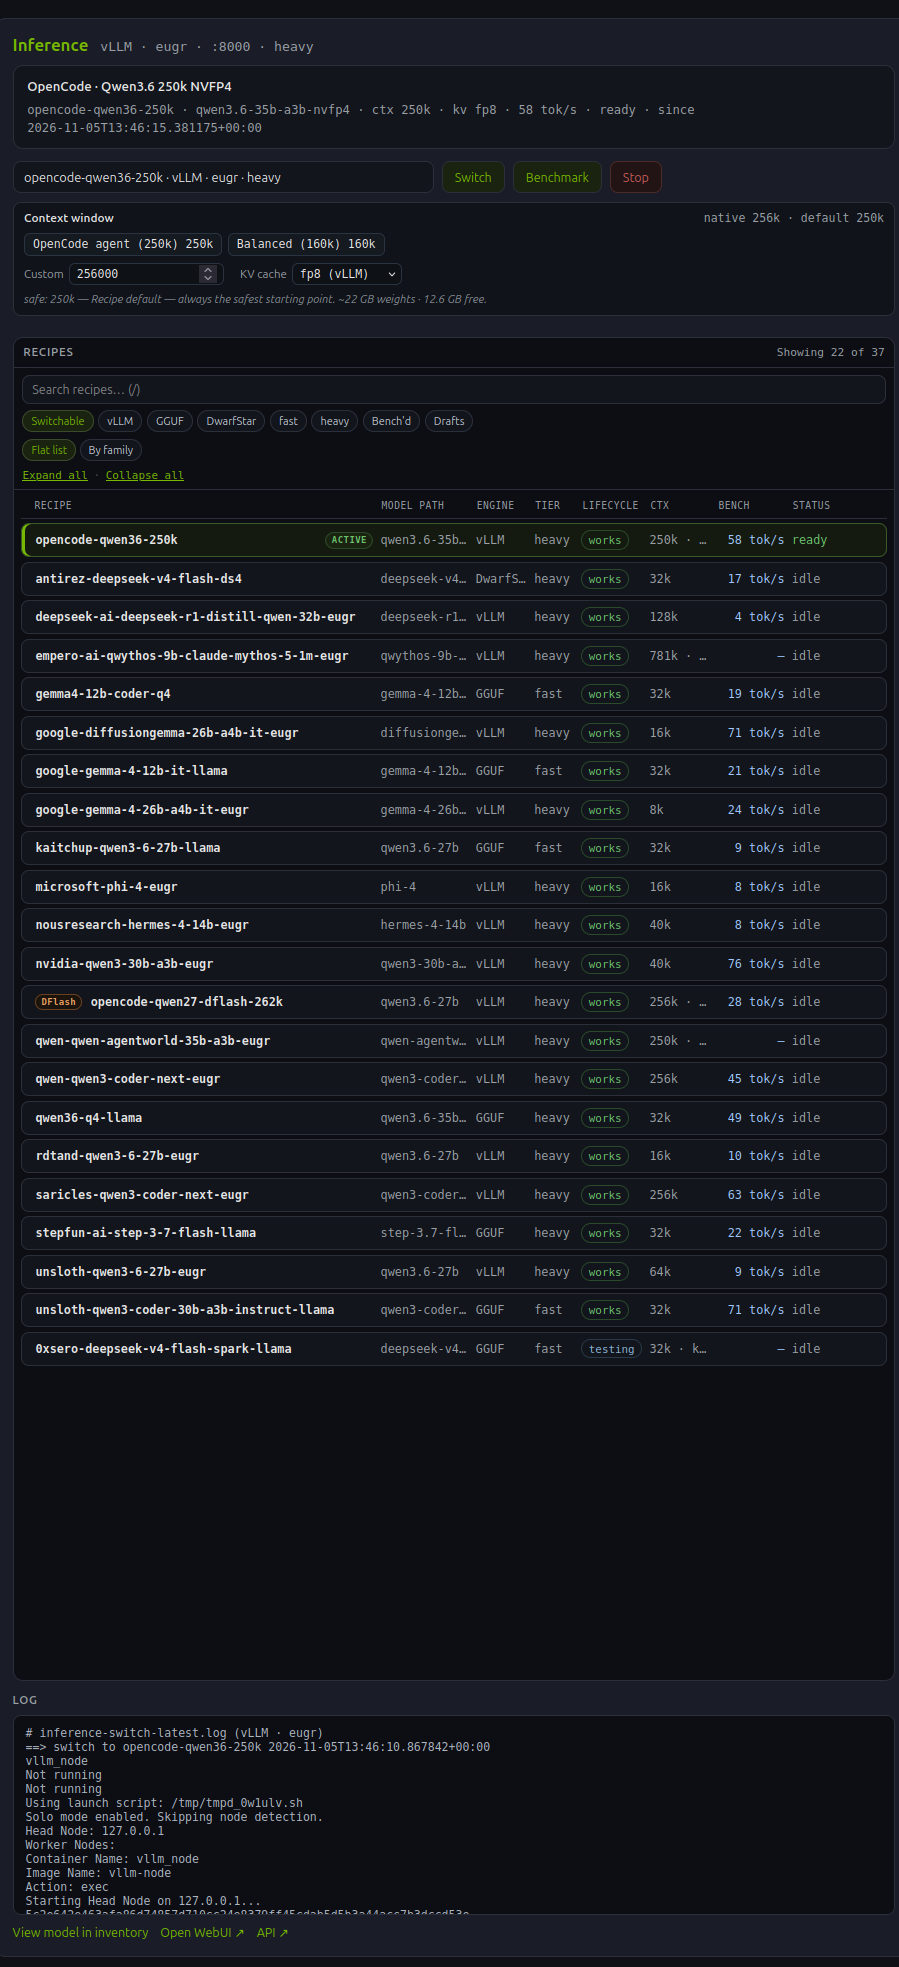
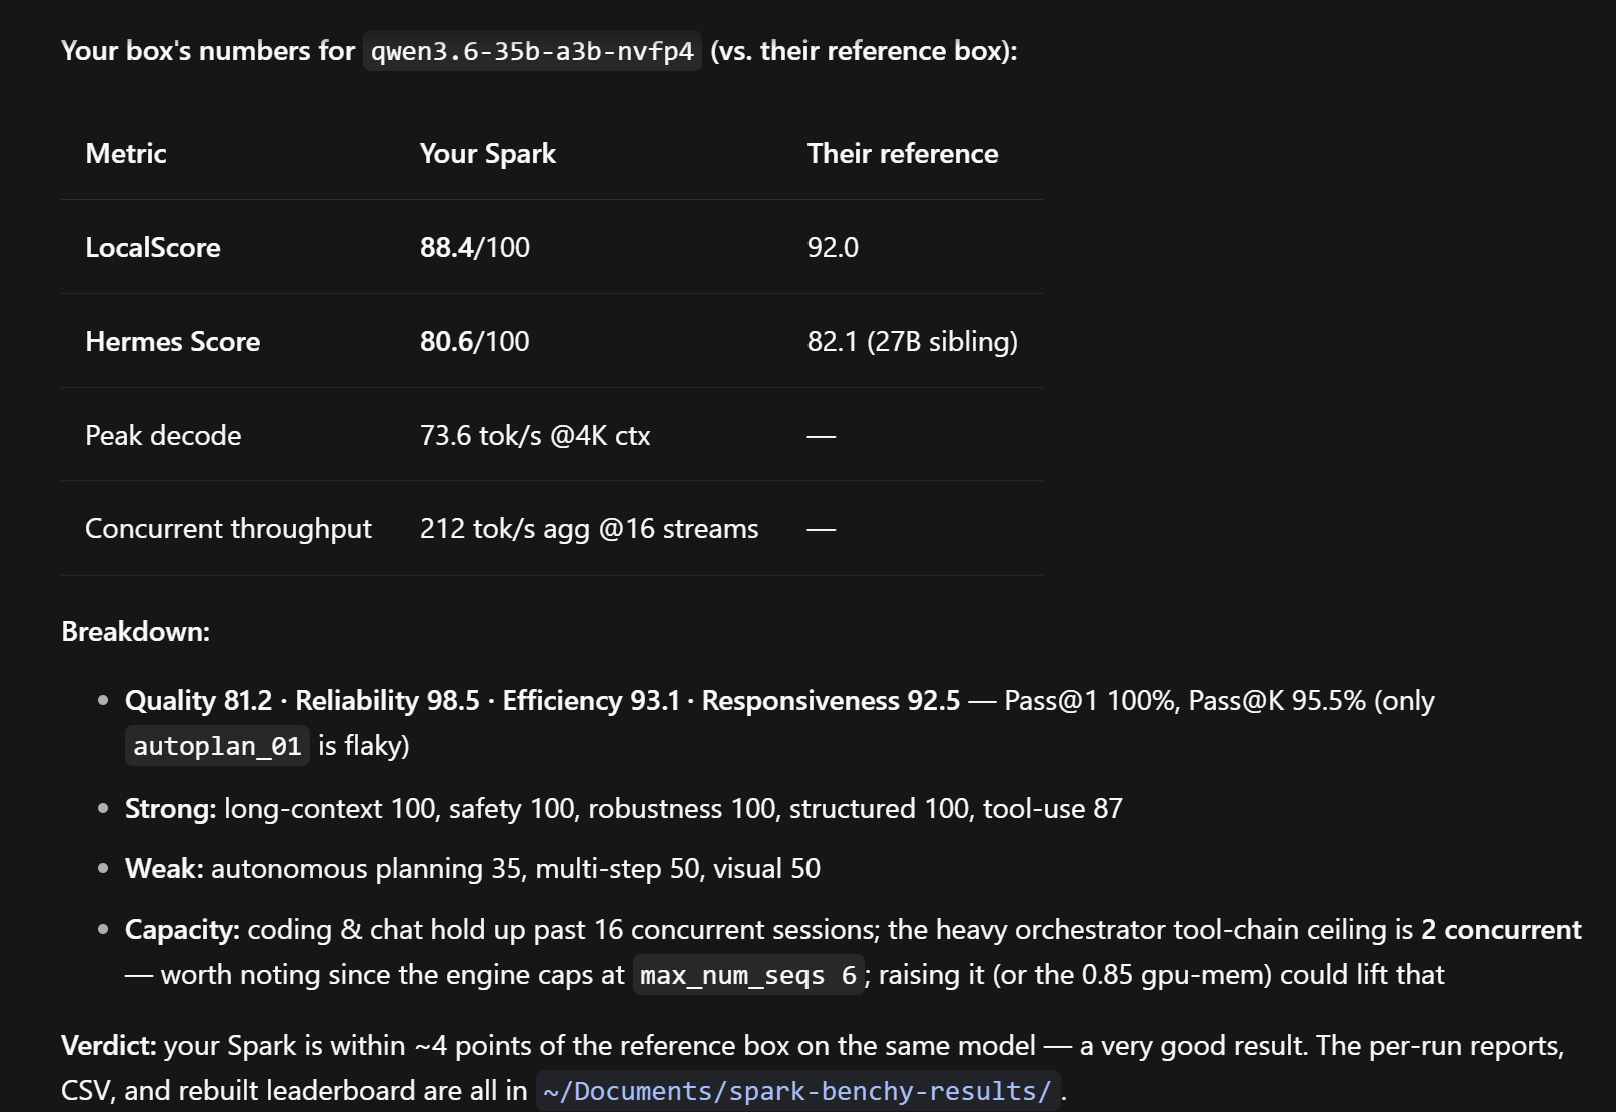
Totusi, daca investiti intr-o astfel de solutie cel mai probabil nu o veti face pentru generare de imagini, sau cel putin nu in acelasi mod in care am testat noi. Drept urmare, am trecut la lucruri mai serioase si am rulat un benchmark pentru inferenta bazat pe Qwen3.6-35b-a3b-nvfp4. Am obtinut o medie de 58 de tokenuri pe secunda, cu un varf de 73.6 tok/s, AI TOP ATOM oferind o rata agregata de transfer de 212 tok/s, utilizand 16 sarcini in paralel.
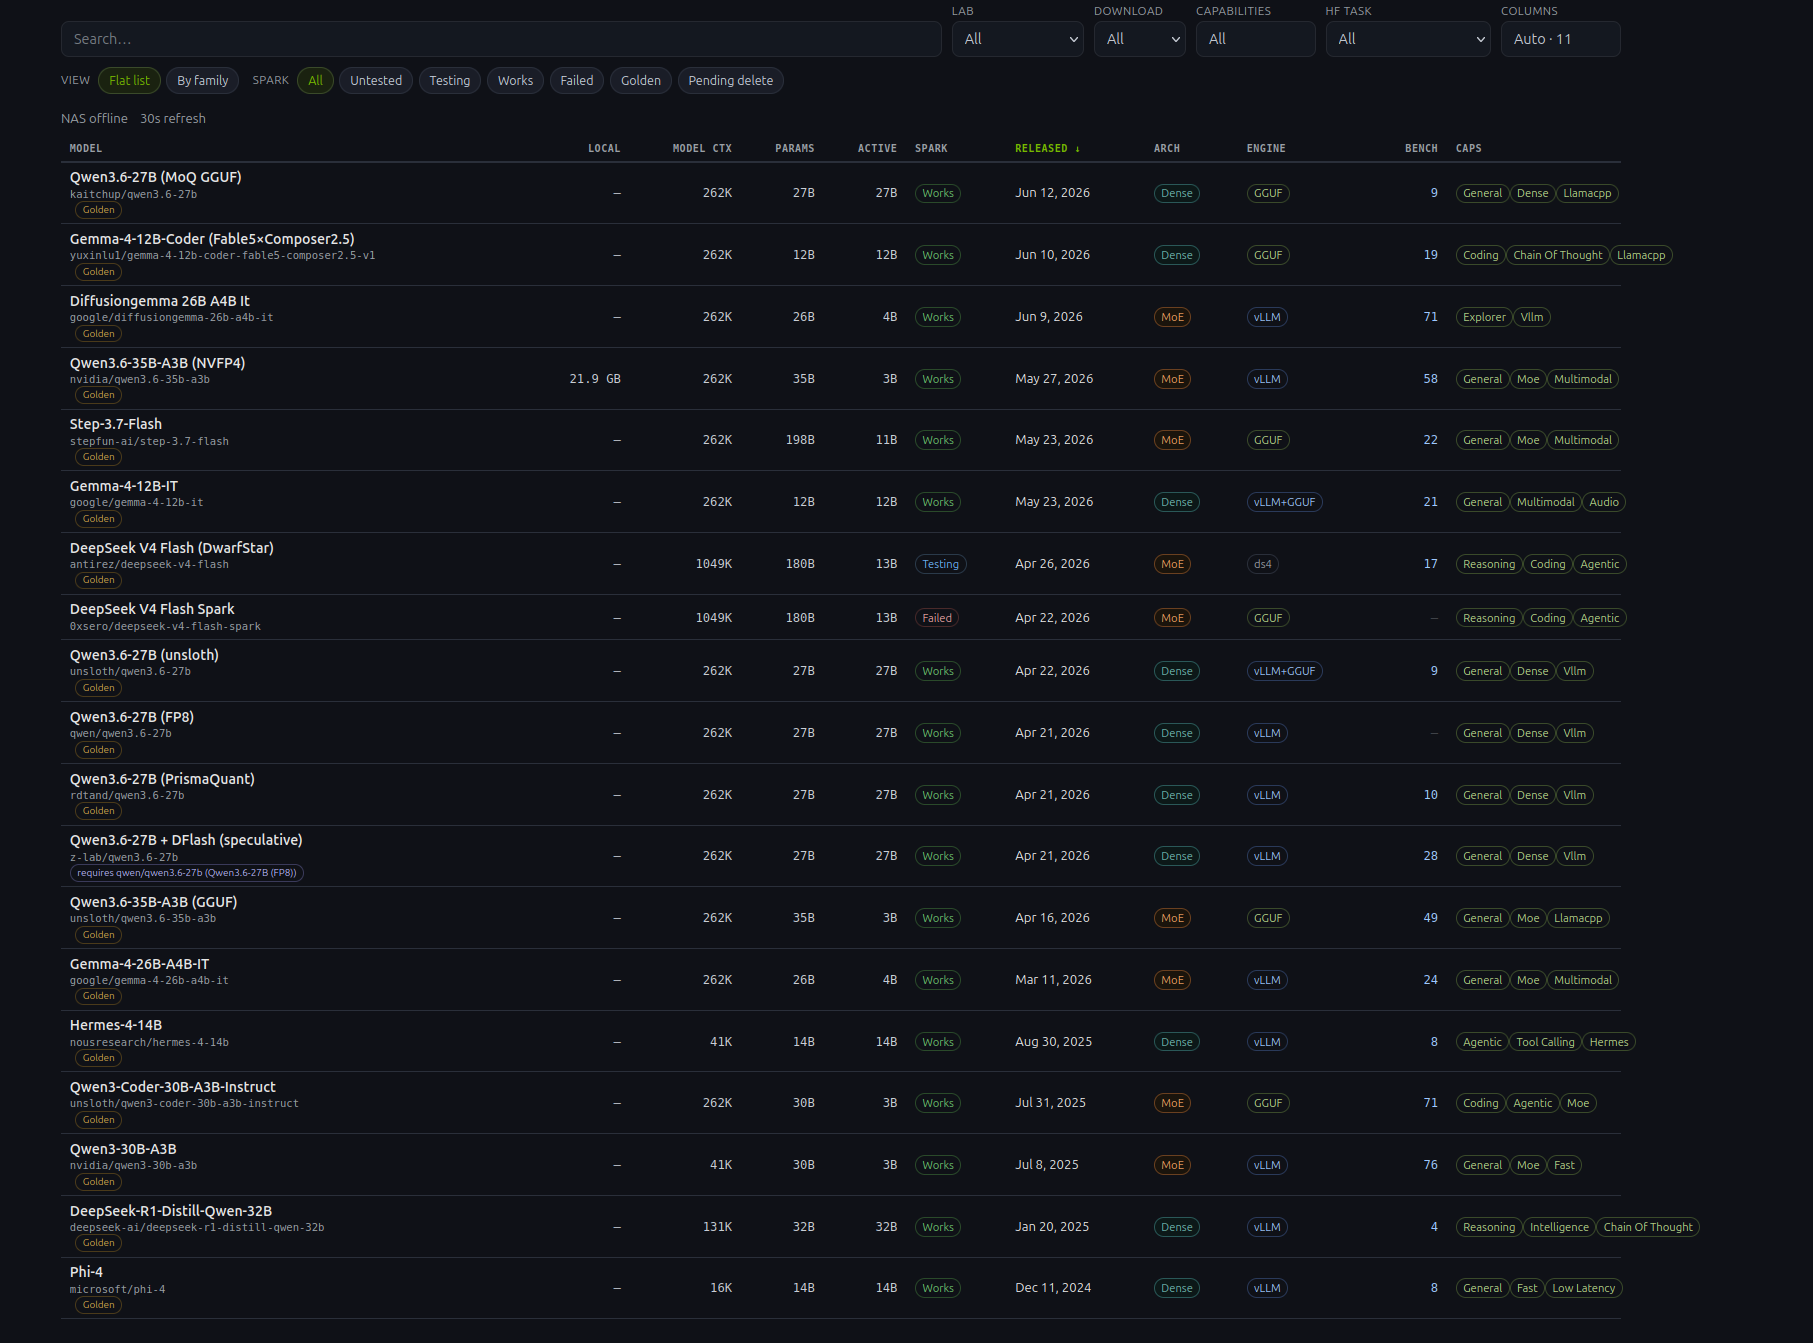
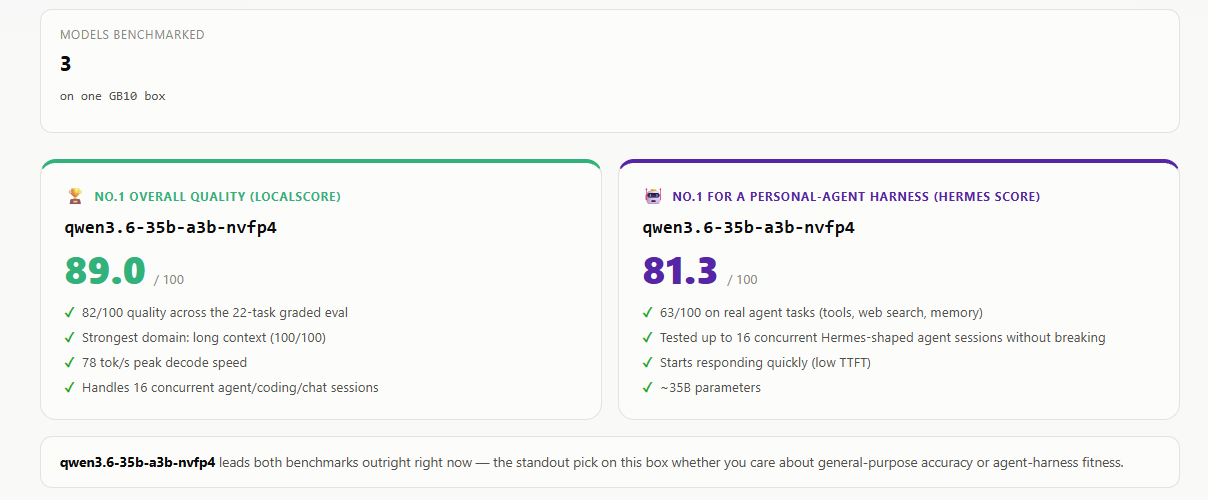
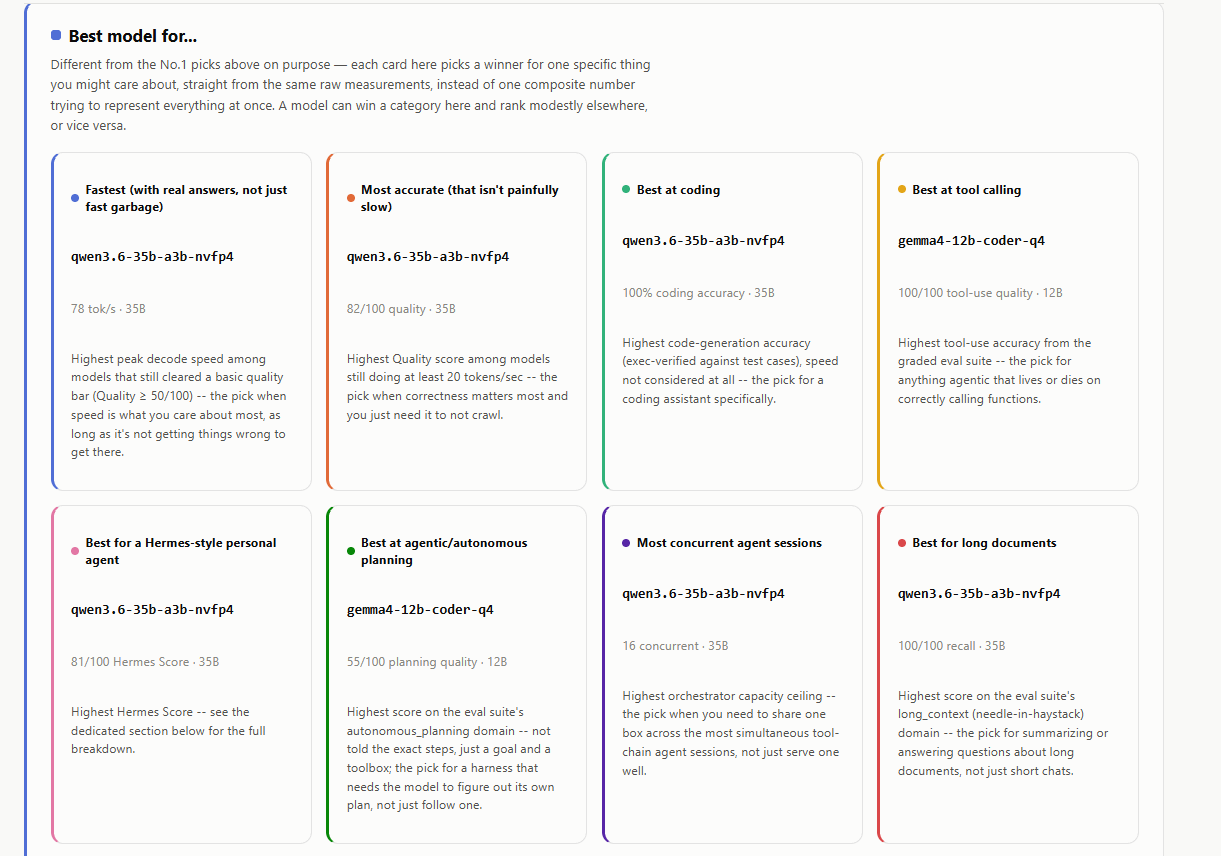
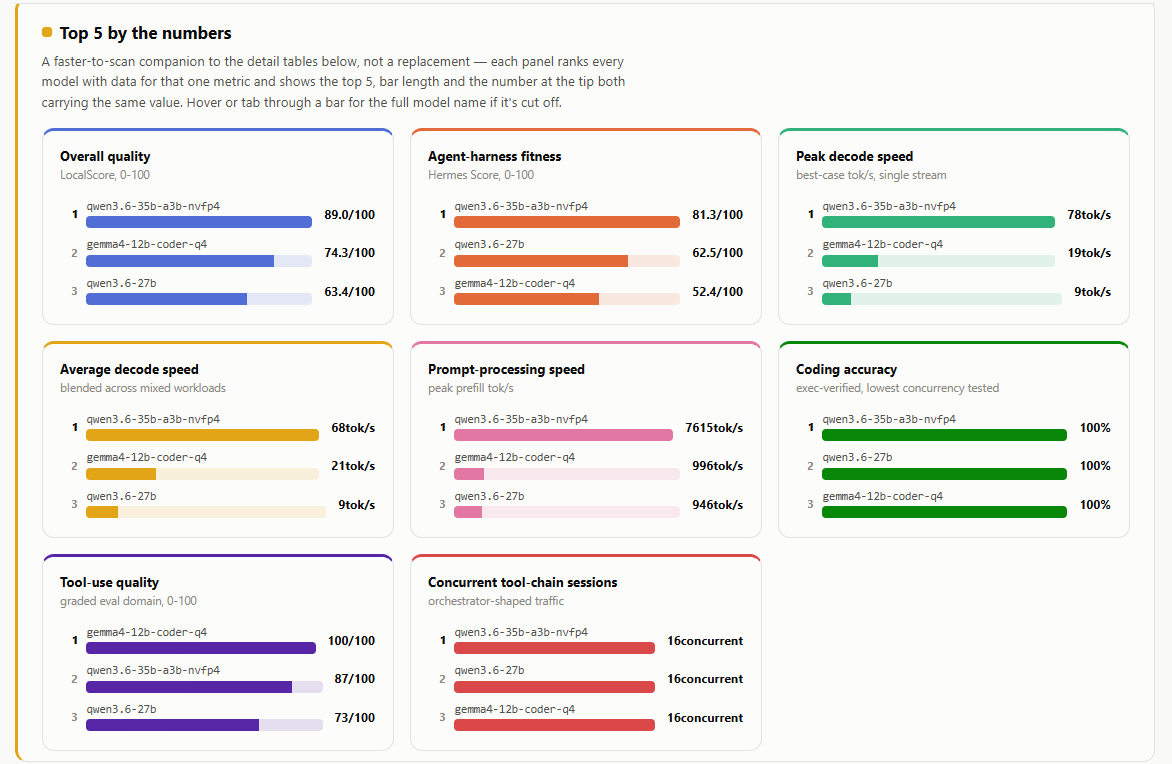
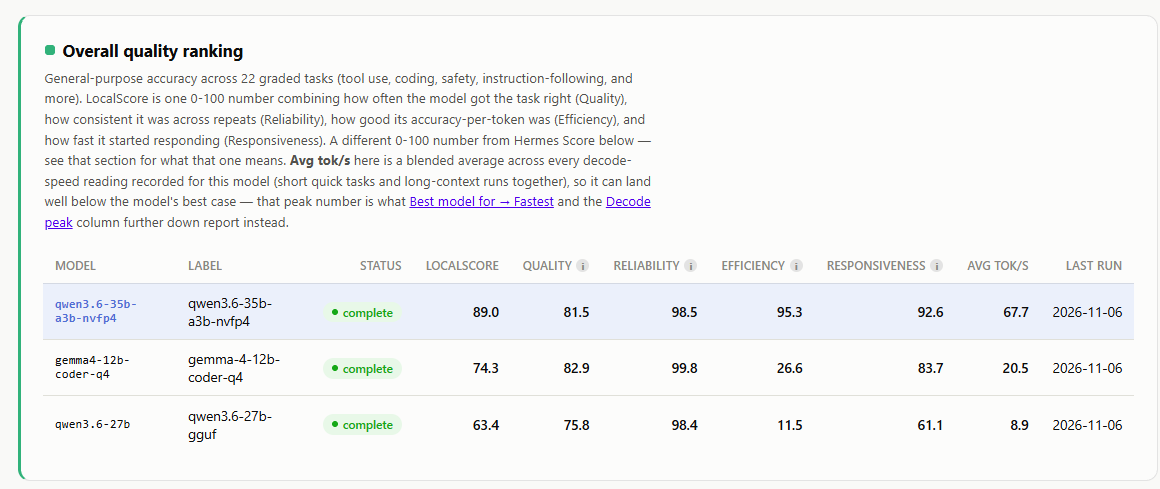
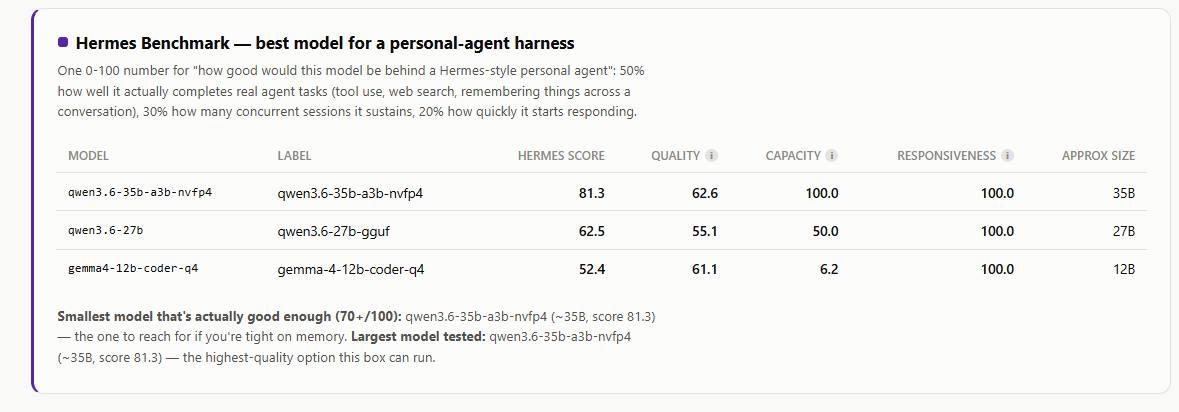
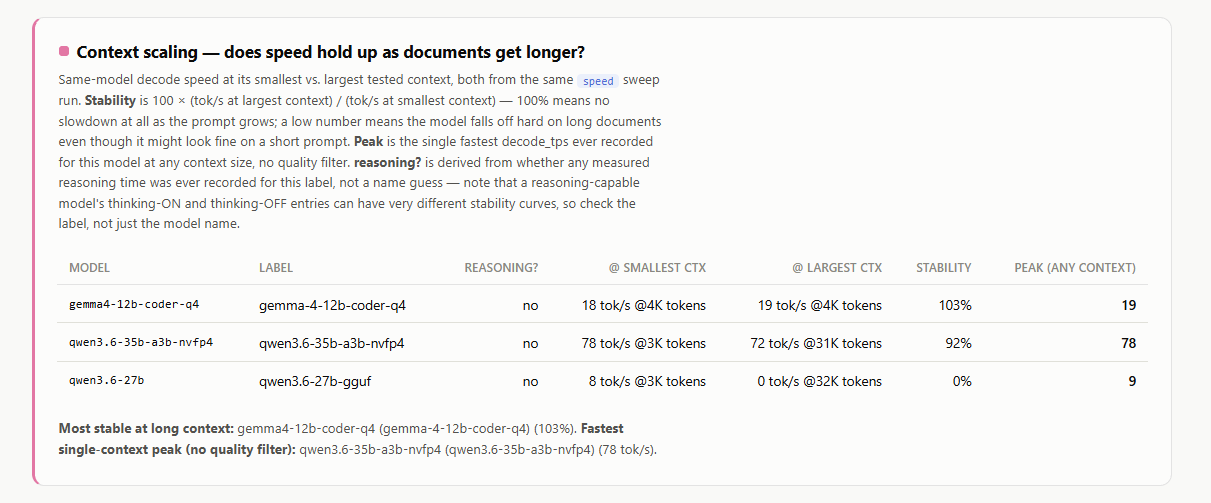
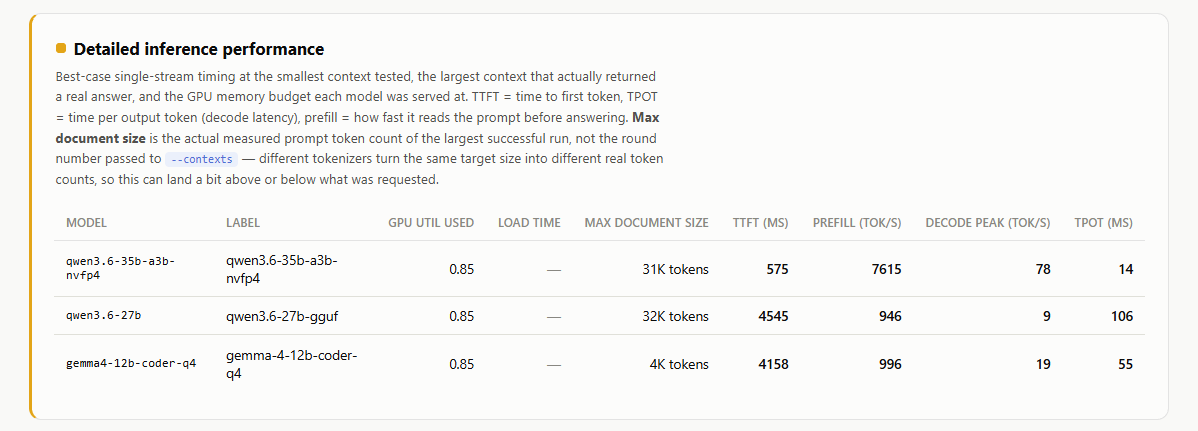
Apoi am comparat performanta a trei modele, mai precis Qwen3.6-35b-a3b-nvfp4 (~35B parametri), Gemma4-12b-coder-q4 (~12B parametri) si Qwen3.6-27b (~27B parametri), urmarind peak decode speed, average decode speed si prompt processing speed (prefill), dar si performanta si precizia in executarea sarcinilor agentice, in cazul de fata Hermes. Asa cum era de asteptat, Qwen3.6-35b se detaseaza relaxat de restul concurentilor, inregistrand o performanta exceptionala pentru viteza de prefill (7615 tok/s), peak decode speed (78 tok/s), respectiv timpul pana la primul token (TTFT) (575 ms).
Modelul Qwen3.6-35b-a3b-nvfp4 obtine 100% precizie verificata in codare si 100/100 la scalarea contextului (suportand pana la 31K – 32K tokeni fara degradari majore de viteza). Pentru tool calling, gemma4-12b-coder-q4 exceleaza, cu un scor perfect de 100/100, fiind ideal pentru sarcini strict agentice. GIGABYTE AI TOP ATOM gestioneaza cu succes pana la 16 sesiuni concurente (chat/coding/agent) in mod stabil, oferind o capacitate excelenta raportata la consum si pret.



Comentarii