Review – GIGABYTE AI TOP ATOM
Cercetare
Am testat de asemenea si un prototip de cercetare dezvoltat intern, exclusiv pe date sintetice. Din pacate, este vorba despre un proiect aflat sub NDA, deci nu va pot oferi momentan detalii legate de scopul acestuia sau domeniul in care va fi aplicat. Ce pot sa va spun este ca acesta combina simulari masive pe GPU, cu milioane pana la miliarde de elemente independente per lot, cu servicii Python pe CPU pentru cautare de date, planificare si semnare criptografica.
Il folosim pentru a rula loturi mari de simulari independente, impreuna cu serviciile care le insotesc. Testul masoara debitul sustinut al fiecarei sarcini de lucru in functie de dimensiunea problemei, cu o statie de lucru dotata cu RTX 3090 drept referinta, mai precis statia pe care a fost dezvoltat initial proiectul.
Fiecare valoare este mediana unor rulari repetate pe o fereastra sustinuta de cel putin 10 s, in float32 daca nu se precizeaza altfel.
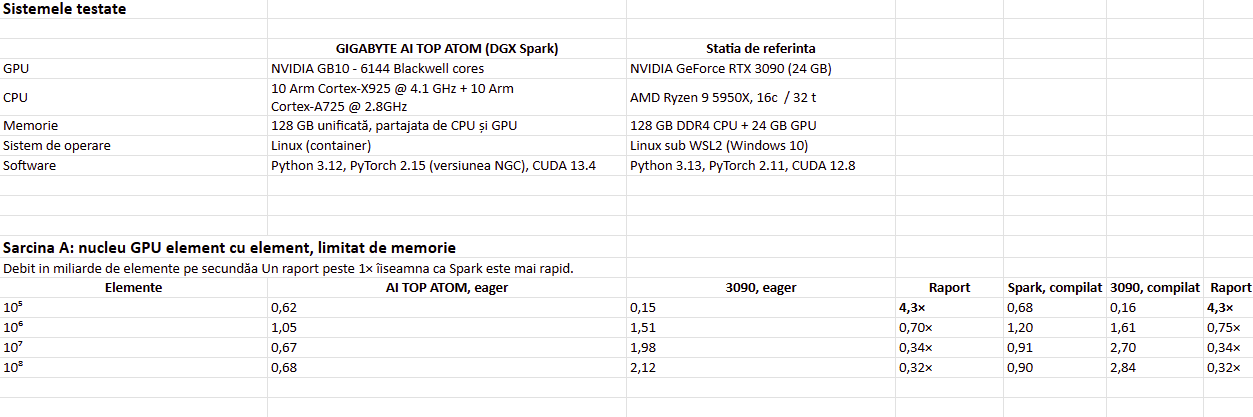
O a doua varianta de date de intrare pentru aceeasi sarcina s-a comportat la fel, cu rapoarte in limita a ±0,1x fata de cele de mai sus.
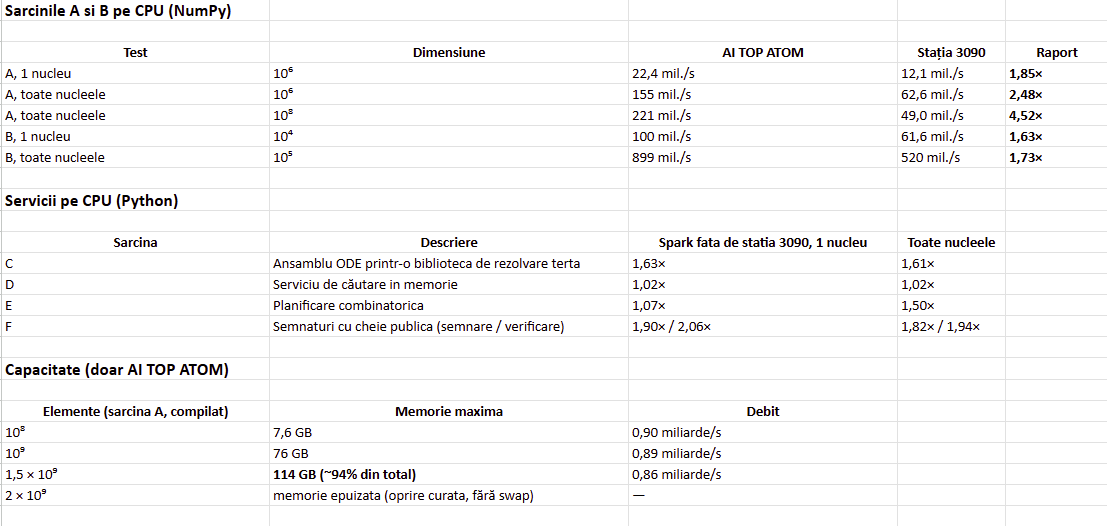
Debitul ramane constant de la 10⁷ la 1,5 × 10⁹ elemente. La aproximativ 76 de octeti per element, cei 24 GB ai placii 3090 ar limita aceasta sarcina la circa 3 × 10⁸ elemente.
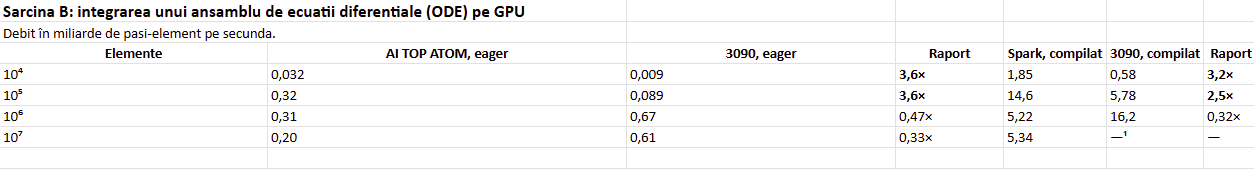
Pentru sarcini mari limitate de latimea de banda a memoriei, RTX 3090 este de aproximativ trei ori mai rapid. De la 10⁶ elemente în sus, statia de referinta ruleaza sarcinile A si B de circa 3 ori mai repede decât GIGABYTE AI TOP ATOM (rapoarte de 0,32–0,34×). Diferenta corespunde aproape exact raportului dintre latimile de banda ale memoriei: circa 936 GB/s pentru memoria GDDR6X a placii 3090, fata de circa 273 GB/s pentru memoria LPDDR5X a lui GB10, adica un raport de ~3,4×. Aceste sarcini fac putine calcule pe fiecare octet citit, deci viteza lor este dictata de cat de repede circula datele prin memorie, nu de puterea de calcul sau cantitatea de memorie. In cazul specific acestui tip de sarcini, o solutie grafica dedicata, echipata cu memorie rapida, ramane solutia ideala.
Pentru loturi mici, Spark raspunde de 3–4 ori mai repede. Sub ~10⁵ elemente, timpul de executie pe 3090 ramâne fix, in jur de 0,65 ms per apel, indiferent de volumul de lucru. Acesta este costul fix de lansare a unei sarcini pe GPU, nu timp de calcul. Pe Spark costul este mai mic. O parte din diferenta vine insa din configuratia de referinta, nu neaparat din diferenta de performanta fata de RTX 3090: aceasta ruleaza sub WSL, unde apelurile catre GPU trec printr-un strat suplimentar de virtualizare, iar placa afiseaza simultan si desktopul Windows. Sub Linux nativ, avantajul lui DGX Spark in cazul loturilor mici ar fi probabil mai mic.
Pe de alta parte, capacitatea este punctul forte distinctiv al platformei DGX Spark. Astfel, datorita memoriei unificate de 128 GB, GIGABYTE AI TOP ATOM a rulat sarcina A pana la 1,5 × 10⁹ elemente (114 GB, ~94% din memorie), cu un debit practic constant, de 0,86–0,90 miliarde de elemente pe secunda. RTX 3090, echipata cu 24 GB, se opreste in jurul valorii de 3 × 10⁸ elemente, de circa cinci ori mai putin. Pentru probleme care nu incap in memoria unui GPU obisnuit, Spark nu este doar mai lent sau mai rapid: este singurul dintre cele doua sisteme care le poate rula integral, fara impartire in bucati.
Pe partea de CPU, Spark castiga clar, iar avantajul creste direct proportional cu dimensiunea problemei. Pe un singur nucleu, GIGABYTE AI TOP ATOM este de 1,6–1,9 ori mai rapid. Pe toate nucleele, la sarcinile mari, avantajul urca pâna la 4,5×, deoarece debitul procesorului din acest test (Zen3, 5950X) scade de la 10⁷ la 10⁸ elemente: memoria DDR4 dual channel (~51 GB/s teoretic) se satureaza. Procesorul integrat in DGX Spark imparte aceeasi memorie LPDDR5X cu nucleul grafic si are la dispozitie de cateva ori mai multa latime de banda. In cazul serviciilor Python mai putin dependente de memorie (sarcina D), cele doua sisteme sunt la egalitate. Daca ne raportam la semnaturile criptografice, GIGABYTE AI TOP ATOM este de ~1,9 ori mai rapid, cel mai probabil si datorita extensiilor criptografice ale arhitecturii ARM.
Practic, DGX Spark nu inlocuieste un GPU dedicat atunci cand debitul brut pentru sarcini poate fi incarcat într-o cantitate limitata de VRAM – desi în 2026 24 GB nu sunt nici pe departe putini. In acest caz, latimea de banda a memoriei GDDR6X domina rezultatele. Pe de alta parte, GIGABYTE AI TOP ATOM este un sistem echilibrat, eficient si compact, cu avantaje importante in aceste sarcini in momentul in care complexitatea simularilor creste, cum ar fi cantitatea uriasa de memorie, accesibila direct atat de catre CPU, cat si de GPU, procesorul ARM puternic, cu acces rapid la memorie, respectiv latenta scazuta CPU – RAM.



Comentarii